Normalización de Bases de Datos
La normalización organiza las relaciones de una base de datos a partir de sus claves y dependencias. Permite reducir ciertas redundancias y evitar anomalías al insertar, actualizar o borrar datos.
Aprenderemos con un caso de matrículas que iremos descomponiendo hasta 3FN. Después veremos por qué existen BCNF y 4FN. Cada separación debe tener un motivo y permitir recuperar la información original.
1. El problema: un mismo hecho aparece en muchas filas #
Una academia guarda las matrículas, el docente de cada curso y el aula asignada a cada docente en una única tabla:
| alumno | curso | docente | aula |
|---|---|---|---|
| 1 | SQL | D1 | A1 |
| 2 | SQL | D1 | A1 |
| 1 | Git | D2 | B2 |
| 3 | CSS | D1 | A1 |
Los alumnos y docentes se identifican mediante códigos: D1 es Eva y D2 es Luis. Los nombres de personas pueden repetirse; por eso no los usamos como claves.
Estas son las reglas de negocio del ejemplo:
- Un alumno puede matricularse en varios cursos, pero solo una vez en cada uno. Aquí no se modelan convocatorias ni cursos académicos.
- Cada código de curso identifica una oferta con un único docente. Un docente puede impartir varios cursos.
- Cada docente tiene una única aula asignada. Varios docentes pueden compartir aula; no se modelan horarios.
Son supuestos de esta academia simplificada. Si un curso admite varios docentes o un docente tiene aulas diferentes según el horario, habría que revisar las dependencias y el esquema.
La tabla repite que SQL lo imparte D1 y que D1 tiene el aula A1. Esto origina tres problemas:
| Anomalía | Qué ocurre en este ejemplo |
|---|---|
| Actualización | Cambiar el aula de D1 exige modificar tres filas. Si solo cambiamos una, tendremos aulas contradictorias para el mismo docente. |
| Inserción | No podemos registrar un nuevo curso sin alumnos usando únicamente matrículas válidas. Tendríamos que inventar un alumno o admitir una fila incompleta. |
| Borrado | Si borramos la última matrícula de Git, también perdemos qué docente imparte Git y cuál es el aula de D2. |
Repetir un identificador como clave foránea es normal. El problema es repetir hechos que podrían mantenerse de forma independiente, como el aula asignada a un docente.
2. Antes de descomponer: claves y dependencias #
Claves candidatas, clave primaria y superclaves #
Una superclave es un conjunto de atributos que identifica de forma única cada fila en cualquier estado válido de la relación. Una clave candidata es una superclave mínima: si quitamos cualquiera de sus atributos, deja de identificar las filas. Elegimos una candidata como clave primaria (PK).
En nuestro ejemplo:
(alumno, curso)es la única clave candidata y la elegimos como PK.(alumno, curso, docente)es una superclave, pero no es mínima:docentesobra para identificar una matrícula.alumnono es clave de Matrículas, porque puede aparecer en varios cursos.
Un atributo es primo si pertenece a alguna clave candidata. En esta relación, alumno y curso son primos; docente y aula son no primos. Esta distinción permite definir con precisión 2FN y 3FN.
Dependencia funcional #
La notación X → Y significa que dos filas con el mismo valor de X deben tener el mismo valor de Y. Decimos que X determina Y.
Las reglas declaradas implican:
1(alumno, curso) → docente, aula
2curso → docente
3docente → aula
Por transitividad, también se cumple curso → aula.
Las dependencias proceden de las reglas de negocio. Una muestra puede mostrar una infracción, pero no demuestra que una dependencia sea válida para todos los datos futuros. Que en una tabla pequeña cada alumno tenga una sola matrícula no convierte alumno en clave.
Una dependencia es trivial cuando todos los atributos de la derecha ya están en la izquierda, como (alumno, curso) → curso. Las formas normales que veremos se centran en las dependencias que aportan restricciones adicionales.
3. Primera forma normal (1FN): quitar listas y grupos repetitivos #
Para trabajar en 1FN, cada atributo contiene un único valor de su dominio por fila y evitamos listas de hechos independientes o grupos repetitivos como curso_1, curso_2, curso_3. Las filas de una relación son distintas; en SQL declaramos una clave para garantizar su identificación.
Por ejemplo, esta representación guarda varias matrículas dentro de una celda:
| alumno | matrículas: curso / docente / aula |
|---|---|
| 1 | SQL / D1 / A1; Git / D2 / B2 |
| 2 | SQL / D1 / A1 |
| 3 | CSS / D1 / A1 |
La transformamos en una fila por matrícula, separando sus atributos:
| alumno (PK) | curso (PK) | docente | aula |
|---|---|---|---|
| 1 | SQL | D1 | A1 |
| 2 | SQL | D1 | A1 |
| 1 | Git | D2 | B2 |
| 3 | CSS | D1 | A1 |
PK en las dos columnas indica una clave compuesta (alumno, curso), no dos claves primarias independientes.
La atomicidad se interpreta según el dominio y el uso del dato. No significa dividir cualquier texto en partes cada vez más pequeñas: guardar un nombre completo no obliga por sí solo a separarlo. Aquí sí necesitamos cada matrícula como un hecho consultable por separado.
La tabla ya está en 1FN, pero conserva las tres anomalías de la introducción. Tener un valor por celda es el primer paso.
4. Segunda forma normal (2FN): depender de toda la clave #
Una relación está en 2FN si está en 1FN y ningún atributo no primo depende de un subconjunto propio de alguna clave candidata. Es decir, no hay dependencias parciales de atributos no primos respecto de las claves candidatas.
En Matrículas, la clave es (alumno, curso), pero:
1curso → docente
2curso → aula
curso es solo una parte de la clave y determina ambos atributos no primos. Son dependencias parciales. Separamos la información del curso:
Matrículas #
| alumno (PK) | curso (PK, FK) |
|---|---|
| 1 | SQL |
| 2 | SQL |
| 1 | Git |
| 3 | CSS |
Cursos #
| curso (PK) | docente | aula |
|---|---|---|
| SQL | D1 | A1 |
| Git | D2 | B2 |
| CSS | D1 | A1 |
Matrículas.curso es una clave foránea (FK) que referencia Cursos.curso.
Ambas relaciones están en 2FN bajo las reglas declaradas: Matrículas no tiene atributos no primos y Cursos tiene una única clave candidata simple, curso.
Ahora podemos registrar un curso sin matrículas y conservarlo aunque pierda todos sus alumnos. Cambiar el docente de SQL requiere actualizar una sola fila de Cursos. Sin embargo, el aula de D1 todavía se repite en SQL y CSS: 2FN no resuelve todas las redundancias.
Atención a las claves alternativas: si todas las claves candidatas son simples, una relación en 1FN está en 2FN. Tener solo la clave primaria simple no basta: podría existir otra clave candidata compuesta con dependencias parciales. Añadir un
idartificial no corrige por sí mismo el diseño.
5. Tercera forma normal (3FN): separar la dependencia transitiva #
En la tabla Cursos todavía se cumple:
1curso → docente → aula
El aula depende transitivamente de curso a través de docente. Como un docente puede impartir varios cursos, docente no es superclave de Cursos. Además, aula es un atributo no primo.
Para evitar repetir el aula del docente, descomponemos Cursos:
Cursos #
| curso (PK) | docente (FK) |
|---|---|
| SQL | D1 |
| Git | D2 |
| CSS | D1 |
Docentes #
| docente (PK) | aula |
|---|---|
| D1 | A1 |
| D2 | B2 |
Matrículas conserva sus columnas (alumno, curso). Ahora Cursos.docente referencia Docentes.docente.
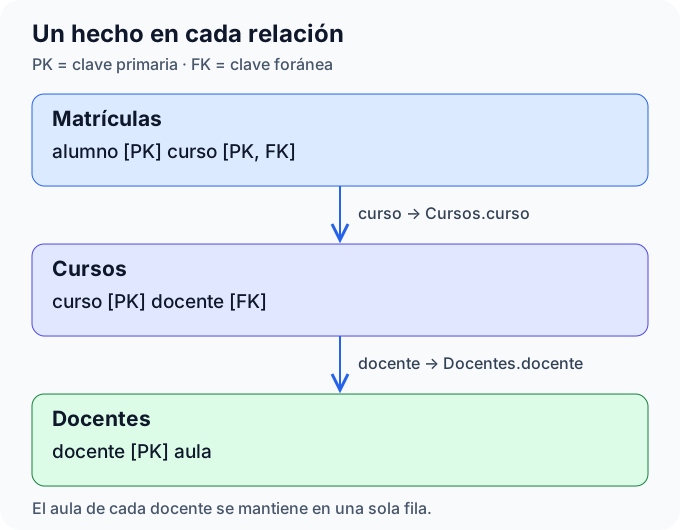
El aula de D1 se almacena una sola vez. También podemos registrar a un docente antes de asignarle cursos. Las tres relaciones están en 3FN y, con estas dependencias, también en BCNF.
Definición precisa de 3FN #
Una relación está en 3FN si, para toda dependencia funcional no trivial X → A con un único atributo A a la derecha, se cumple al menos una de estas condiciones:
- X es una superclave.
- A es un atributo primo: pertenece a alguna clave candidata.
La idea de «eliminar dependencias transitivas entre atributos no clave» ayuda en los ejemplos básicos. La definición completa es necesaria cuando existen varias claves candidatas que comparten atributos.
En Cursos antes de la separación, docente → aula incumplía ambas condiciones. Después, en Docentes, docente sí es clave.
Llevar el resultado a SQL #
Estas tablas implementan el esquema final. Se supone que el catálogo de alumnos ya existe; en un sistema completo, alumno también referenciaría su clave.
1CREATE TABLE Docentes (
2  docente VARCHAR(10) PRIMARY KEY,
3  aula VARCHAR(10) NOT NULL
4);
5
6CREATE TABLE Cursos (
7  curso VARCHAR(30) PRIMARY KEY,
8  docente VARCHAR(10) NOT NULL,
9  FOREIGN KEY (docente) REFERENCES Docentes(docente)
10);
11
12CREATE TABLE Matriculas (
13  alumno INT NOT NULL,
14  curso VARCHAR(30) NOT NULL,
15  PRIMARY KEY (alumno, curso),
16  FOREIGN KEY (curso) REFERENCES Cursos(curso)
17);
Las restricciones PRIMARY KEY, FOREIGN KEY y NOT NULL hacen cumplir parte de las reglas del modelo. Normalizar y declarar restricciones son tareas complementarias.
6. Descomponer sin perder información #
Una descomposición sin pérdida permite reconstruir exactamente la relación original al unir sus proyecciones: no desaparecen filas ni aparecen combinaciones que antes no existían, llamadas tuplas espurias.
En nuestro ejemplo recuperamos las cuatro matrículas iniciales con:
1SELECT m.alumno, m.curso, c.docente, d.aula
2FROM Matriculas AS m
3JOIN Cursos AS c ON c.curso = m.curso
4JOIN Docentes AS d ON d.docente = c.docente;
Los nuevos cursos sin matrículas no aparecen en esta consulta: estamos reconstruyendo la información de matrículas, mientras que el nuevo esquema permite guardar también hechos independientes.
Para una descomposición binaria basada en dependencias funcionales, podemos comprobar que los atributos comunes determinan todos los atributos de al menos una de las dos relaciones:
- Matrículas y Cursos comparten
curso, que es clave de Cursos. - Cursos y Docentes comparten
docente, que es clave de Docentes.
Otra propiedad es la preservación de dependencias: poder comprobar las reglas originales sobre las tablas resultantes sin unirlas. Aquí curso → docente queda en Cursos y docente → aula en Docentes; la PK de Matrículas impide repetir una matrícula.
Obtener tablas en una forma normal no basta para justificar cualquier separación. Hay que comprobar la reconstrucción sin pérdida y analizar qué dependencias se conservan.
7. Boyce-Codd (BCNF): todo determinante debe ser superclave #
Una relación está en BCNF si, para toda dependencia funcional no trivial X → Y, X es una superclave. Es más exigente que 3FN: no admite la excepción de que el atributo de la derecha sea primo.
Veamos por qué importa con otra relación:
1Tutorias(alumno, asignatura, docente)
2
3(alumno, asignatura) → docente
4docente → asignatura
Suponemos que cada alumno tiene un único tutor por asignatura, cada docente tutoriza una única asignatura y puede atender a varios alumnos. Una asignatura puede tener varios docentes.
Las claves candidatas son (alumno, asignatura) y (alumno, docente). Por tanto, los tres atributos son primos. La relación cumple 3FN, pero no BCNF: en docente → asignatura, docente no es superclave.
Una descomposición en BCNF es:
1DocentesAsignaturas(docente PK, asignatura)
2AlumnosDocentes(alumno PK, docente PK y FK)
Es sin pérdida porque el atributo compartido, docente, determina toda la primera relación. Sin embargo, no preserva directamente (alumno, asignatura) → docente: con las restricciones locales podríamos asignar a un alumno dos docentes de la misma asignatura. Esa regla requeriría una comprobación adicional entre tablas.
Este caso muestra por qué una descomposición en BCNF puede exigir decisiones que no aparecen en los ejemplos básicos de 3FN.
8. Cuarta forma normal (4FN): separar conjuntos independientes #
Las dependencias funcionales no explican todos los casos de redundancia. Supongamos ahora que registramos los proyectos de cada empleado y sus habilidades generales.
La regla es explícita: las habilidades del empleado son independientes de los proyectos en los que participa. No estamos indicando qué habilidad utiliza en cada proyecto.
Para un empleado con dos proyectos y dos habilidades, la tabla conjunta debe recoger las cuatro combinaciones:
| empleado (PK) | proyecto (PK) | habilidad (PK) |
|---|---|---|
| E1 | P1 | Java |
| E1 | P1 | SQL |
| E1 | P2 | Java |
| E1 | P2 | SQL |
La única clave candidata es (empleado, proyecto, habilidad): empleado por sí solo no identifica una fila. Suponemos que no hay otras dependencias funcionales no triviales, por lo que esta relación está en BCNF.
Aquí existen dependencias multivaluadas, que escribimos con una doble flecha:
1empleado →→ proyecto
2empleado →→ habilidad
Para un empleado fijo, sus proyectos pueden combinarse libremente con sus habilidades. Por eso, al añadir una habilidad, debemos repetirla para todos sus proyectos. Tener varios valores asociados a un empleado no vulnera 1FN: cada celda sigue conteniendo un solo valor.
Descomposición en 4FN #
EmpleadosProyectos, PK (empleado, proyecto):
| empleado (PK) | proyecto (PK) |
|---|---|
| E1 | P1 |
| E1 | P2 |
EmpleadosHabilidades, PK (empleado, habilidad):
| empleado (PK) | habilidad (PK) |
|---|---|
| E1 | Java |
| E1 | SQL |
En un esquema completo, empleado y proyecto referenciarían sus respectivos catálogos. Bajo las dependencias declaradas, ambas relaciones están en 4FN.
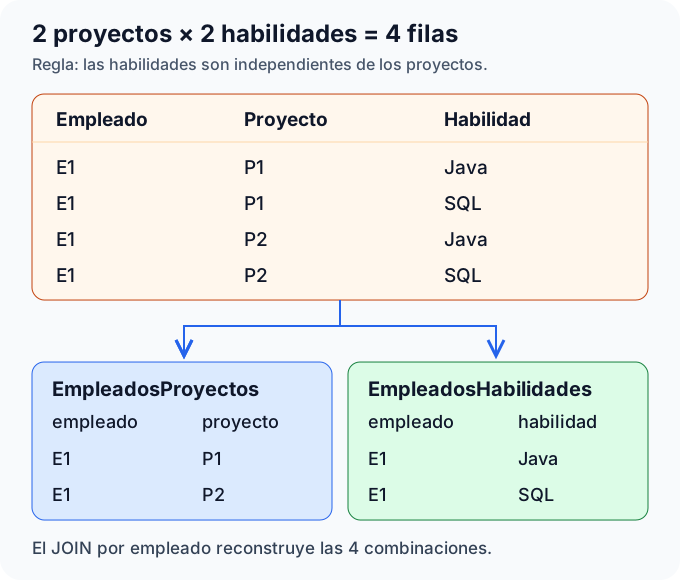
El JOIN por empleado reconstruye exactamente las cuatro combinaciones. Si la relación original indicara qué habilidad se aplica a cada proyecto, la independencia no estaría garantizada y esta separación podría inventar asociaciones.
Definición precisa de 4FN #
Una relación está en 4FN si, para cada dependencia multivaluada no trivial X →→ Y, X es una superclave. Es trivial si Y está contenido en X o si X e Y juntos abarcan todos los atributos de la relación.
En la tabla original, empleado →→ proyecto es no trivial y empleado no es superclave: incumple 4FN. En cada tabla descompuesta, esa dependencia es trivial porque abarca todos sus atributos.
La 4FN implica BCNF. La jerarquía que hemos estudiado es:
14FN ⇒ BCNF ⇒ 3FN ⇒ 2FN ⇒ 1FN
¿Y la quinta forma normal (5FN)? #
La 5FN estudia dependencias de unión: casos en los que una relación puede reconstruirse sin pérdida a partir de varias proyecciones. Exige que las dependencias de unión no triviales estén implicadas por las claves candidatas.
No se puede dividir cualquier relación de tres columnas en tres relaciones de dos columnas: hacen falta reglas que justifiquen la reconstrucción exacta. Profundizaremos en el ejercicio de 5FN.
9. Laboratorio: comprueba las anomalías #
El simulador utiliza las mismas reglas del caso principal. Muestra directamente los nombres Eva y Luis como identificadores simplificados de D1 y D2; en una aplicación real conviene mantener códigos estables.
- Selecciona 1FN y pulsa Cambiar docente SQL a Nora. ¿Por qué aparecen dos docentes para SQL?
- Vuelve a seleccionar 1FN y borra todas las matrículas de SQL. ¿Qué información del curso desaparece?
- Selecciona 2FN y cambia el aula de Eva a Z9. Compara SQL y CSS: ¿qué dependencia sigue causando contradicciones?
- Selecciona 3FN y repite el cambio de aula. ¿En qué tabla se realiza ahora una única actualización?
- En 3FN, borra las matrículas de SQL. Comprueba que el curso conserva su docente.
Cada cambio de forma normal restaura los datos iniciales para facilitar la comparación.
Laboratorio interactivo
Normalización y anomalías
Una matrícula ya está en 1FN. Descompón hasta 3FN y compara el efecto de actualizar o borrar datos. Dependencias de este ejemplo: curso → docente y docente → aula.
(alumno, curso) → docente, aula. curso → docente es parcial: depende de parte de la clave.
Matrículas · 4 filas
| alumno | curso | docente | aula |
|---|---|---|---|
| 1 | SQL | Eva | A1 |
| 2 | SQL | Eva | A1 |
| 1 | Git | Luis | B2 |
| 3 | CSS | Eva | A1 |
Datos coherentes. La clave de Matrículas es (alumno, curso). Sin contradicciones entre las filas actuales.
La forma normal depende de las dependencias declaradas, no solo de los datos visibles. Al cambiar de modelo se restaura el ejemplo. Este laboratorio parte de 1FN y no cubre BCNF.
Experimenta: En 1FN cambia solo la primera fila SQL. Observa la contradicción. En 2FN cambia el aula de Eva y encuentra la dependencia transitiva; en 3FN el aula se guarda una vez.
Soluciones del laboratorio
- En 1FN se modifica una matrícula y la otra matrícula de SQL mantiene el docente anterior: se incumple
curso → docente. - Desaparecen el docente y el aula asociados a SQL en esa tabla. Eva todavía aparece en CSS, pero ya no queda registrado quién imparte SQL.
- En 2FN permanece
docente → auladentro de Cursos. El aula de Eva se guarda en más de una fila. - En 3FN basta actualizar la fila de Eva en Docentes. Los cursos consultan esa misma asignación.
- Cursos mantiene SQL aunque ya no existan matrículas para ese curso.
10. Practica: justifica cada separación #
Ejercicio A: una dependencia de parte de la clave #
1Inscripciones(id_alumno, id_materia, direccion_alumno, profesor)
2PK: (id_alumno, id_materia)
3
4id_alumno → direccion_alumno
5id_materia → profesor
Suponemos que esta es la única clave candidata, los valores son atómicos y no hay más dependencias independientes. ¿Está en 2FN? Propón una descomposición e indica sus claves.
Ver solución A
No está en 2FN: direccion_alumno y profesor dependen de partes distintas de la clave compuesta. Hay que separar ambas dependencias:
1Alumnos(id_alumno PK, direccion_alumno)
2Materias(id_materia PK, profesor)
3Inscripciones(id_alumno PK y FK, id_materia PK y FK)
Dejar profesor en Inscripciones mantendría una dependencia parcial. Las FK de Inscripciones referencian Alumnos y Materias. Los atributos compartidos son claves de las relaciones de destino, por lo que podemos reconstruir la relación original sin pérdida.
Ejercicio B: un dato de otra entidad #
1Empleados(id_empleado, nombre, id_departamento, nombre_departamento)
2PK: id_empleado
3
4id_empleado → nombre, id_departamento
5id_departamento → nombre_departamento
Suponemos que id_empleado es la única clave candidata y cada empleado pertenece a un departamento. ¿Qué impide alcanzar 3FN?
Ver solución B
La relación está en 2FN, pero id_departamento → nombre_departamento viola 3FN: el determinante no es superclave y el atributo determinado no es primo. Separamos:
1Empleados(id_empleado PK, nombre, id_departamento FK)
2Departamentos(id_departamento PK, nombre_departamento)
Así, cambiar el nombre de un departamento exige actualizar una sola fila, aunque tenga muchos empleados.
Ejercicio C: comprobar la independencia #
Una tabla EmpleadosProyectosHabilidades solo contiene (E1, P1, Java) y (E1, P2, SQL). Si la dividimos en pares empleado-proyecto y empleado-habilidad, ¿qué ocurre al unirlos?
Ver solución C
El JOIN produce cuatro filas: añade (E1, P1, SQL) y (E1, P2, Java). Esas dos combinaciones no estaban en la tabla inicial.
Si cada fila expresa una habilidad utilizada en un proyecto, la descomposición pierde esa asociación e introduce tuplas espurias. Si pretendíamos modelar conjuntos independientes, la tabla inicial estaba incompleta para esa regla. Antes de descomponer hay que aclarar qué hecho representa cada fila.
11. Guía de repaso #
| Forma normal | Qué comprobar |
|---|---|
| 1FN | Un valor por atributo y fila, sin listas de hechos ni grupos repetitivos. |
| 2FN | Ningún atributo no primo depende de una parte propia de alguna clave candidata. |
| 3FN | En cada dependencia funcional no trivial X → A, X es superclave o A es primo. |
| BCNF | En cada dependencia funcional no trivial, el determinante es superclave. |
| 4FN | En cada dependencia multivaluada no trivial, el determinante es superclave. |
Antes de dar por terminado un diseño, declara las reglas de negocio, identifica todas las claves candidatas, justifica cada separación y comprueba que el JOIN reconstruye la información. Revisa también qué dependencias pueden validarse en las tablas resultantes.
Normalizar reduce determinadas anomalías; no elimina toda repetición ni garantiza por sí solo la integridad o el rendimiento. Un diseño en 3FN/BCNF suele ser un buen punto de partida. La desnormalización por rendimiento debe responder a necesidades medidas y mantener la coherencia de los datos.
Resumen del tema
- Las dependencias y las claves se deducen de las reglas de negocio, no solo de las filas visibles.
- 1FN elimina listas y grupos repetitivos; 2FN trata dependencias parciales; 3FN y BCNF afinan el tratamiento de las dependencias funcionales.
- 4FN separa conjuntos independientes cuando una dependencia multivaluada no trivial tiene un determinante que no es superclave.
- Una descomposición correcta debe reconstruir los datos sin pérdida. Preservar dependencias es una propiedad distinta.
- Las claves foráneas pueden repetirse. Añadir un identificador artificial no elimina las dependencias que causan redundancia.
Para ampliar las definiciones y los criterios de descomposición, consulta los apuntes de normalización de RPI y el material de Purdue sobre normalización y dependencias multivaluadas.